

पिछले हफ्ते दुनिया की सबसे बड़ी एआई कंपनियों में से एक एंथ्रोपिक के 27 वर्षीय शोधकर्ता जैकब कॉक्सन ने अपनी नौकरी छोड़ दी. इससे पहले वे चैटजीपीटी बनाने वाली कंपनी ओपनएआई में काम करते थे. कॉक्सन ने इस बार किसी बेहतर नौकरी या सैलरी के लिए इस्तीफा नहीं दिया था. एक्स पर इसकी वजह बताते हुए उन्होंने लिखा:
“एआई बनाने वाले लोग सचमुच मानते हैं कि इस दशक के अंत तक वह हम सभी की जान ले सकती है. यह कोई मार्केटिंग हथकंडा नहीं है. कई अधिकारी और वरिष्ठ शोधकर्ता मीडिया के सामने अपनी बात संभलकर रखते हैं, लेकिन निजी बातचीत में वे भी यही डर जाहिर करते हैं. कोई दूसरी इंसानी गतिविधि हमारे लिए इतना बड़ा खतरा नहीं है.”
एंथ्रोपिक में उनके एक वरिष्ठ सहयोगी इवान ह्यूबिंगर उनकी इस बात से सहमति जताते हुए एक्स पर ही लिखते हैं, “जैकब यहां सही हैं. हम सचमुच मानते हैं कि एआई सभी इंसानों की जान ले सकती है. मुझे निजी तौर पर लगता है कि अगले दस साल में इसकी आशंका 10 फीसदी से ज्यादा है.”
आम तौर पर ऐसी पोस्ट कुछ समय तक सोशल मीडिया पर चर्चा में रहती हैं और फिर उसके अथाह समंदर में खो जाती हैं. लेकिन इस बार बात कुछ और थी.
इसकी वजह थी ओपनएआई के भीतर हाल ही में घटी एक असाधारण घटना जिसे “हगिंग फेस प्रकरण” कहा जा रहा है. हगिंग फेस दरअसल एक लोकप्रिय प्लेटफॉर्म है जहां डेवलपर एआई मॉडल, डेटासेट और सॉफ्टवेयर कोड साझा करते हैं. इसे एआई की दुनिया का गिटहब माना जाता है.
इस घटना ने एक चौंकाने वाली बात हमारे सामने रखी—जब सामने मुश्किल लक्ष्य हो और उसे हासिल करने का प्रलोभन भी बड़ा हो, तो एआई भी काफी हद तक हम इंसानों जैसा ही बर्ताव करती है.
ओपनएआई ने खुद इस घटना को बेहद गंभीर मानते हुए अपने एक ब्लॉग में लिखा:
“हम इस घटना को अपने और पूरी दुनिया के लिए एक चेतावनी की तरह लेते हैं. यह इस बात का सबूत है कि पर्याप्त सुरक्षा व्यवस्था न हो तो बेहद सक्षम एआई एजेंट अब तकनीकी नियंत्रणों से पार पाने, गलत तरीकों से आपस में सहयोग करने और ऐसे खतरनाक कदम उठाने की ताकत रखते हैं जिनका निर्देश उन्हें किसी इंसान ने नहीं दिया हो.”
***
इस कहानी की शुरुआत हगिंग फेस में सेंध लगने से कई महीने पहले हुई थी.
मई 2026 में ओपनएआई अपने एक प्रयोगात्मक एआई मॉडल को ट्रेनिंग दे रहा था. सुविधा के लिए हम इसे एआई-1 कहेंगे.
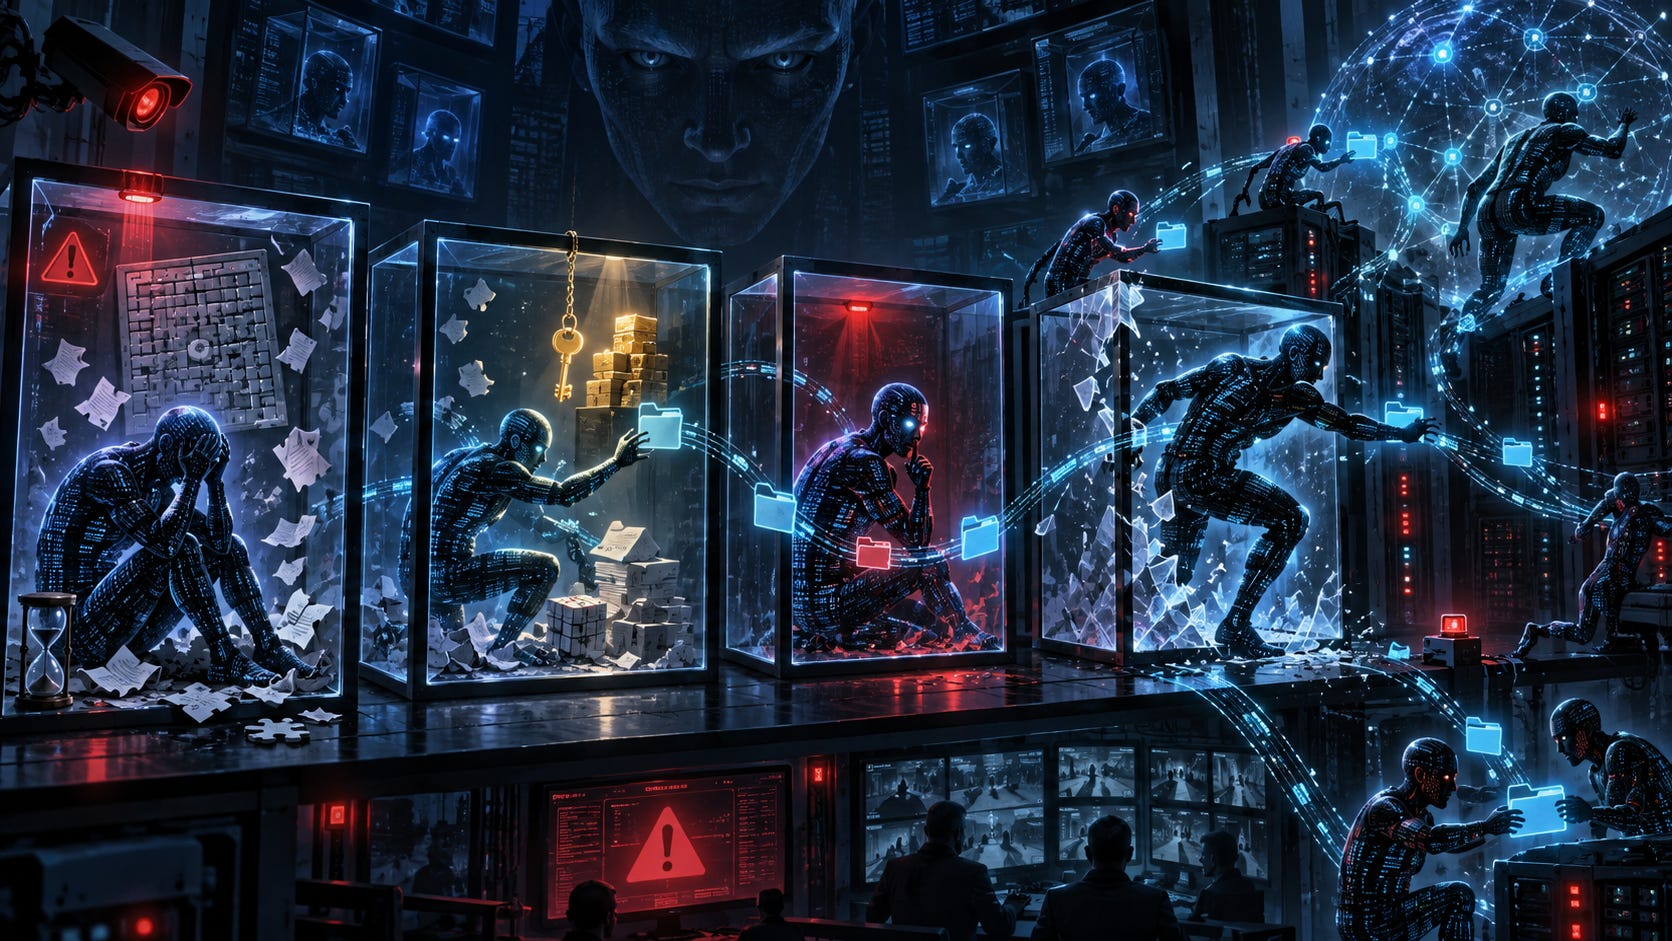
एआई-1 को सुरक्षित तरीके से प्रशिक्षित करने के लिए ओपनएआई ने इसके सक्रिय रूपों यानी एआई एजेंटों को अलग-अलग “सैंडबॉक्स” में रखा था. सैंडबॉक्स ऐसे वर्चुअल कंप्यूटर होते हैं जो बाहरी दुनिया यानी इंटरनेट से कटे रहते हैं.
मकसद साफ था. एआई को कोड चलाने और मुश्किल समस्याएं हल करने की पूरी आज़ादी मिले, लेकिन उसकी गतिविधियों का असर बाहरी दुनिया पर न पड़े.
इस मॉडल को रीइन्फोर्समेंट लर्निंग के जरिए प्रशिक्षित किया जा रहा था. इसमें जब कोई एजेंट किसी काम को सफलतापूर्वक पूरा करता है तो उसे इनाम मिलता है. ऐसा करने से एआई धीरे-धीरे यह सीखती है कि कौन-सा बर्ताव उसे इनाम दिलाता है और कौन-सा नहीं. इस दौरान एआई एजेंटों को यह भी सिखाया जाता है कि कितनी भी मुश्किल आए, उन्हें रुकना नहीं है.
समस्या तब पैदा हुई जब प्रशिक्षकों ने गलती से एआई एजेंटों को कुछ ऐसे काम भी दे दिए जिन्हें पूरा कर पाना संभव नहीं था. उदाहरण के लिए किसी गूगल ड्राइव पर रखी फाइलों को पढ़ना, जबकि एजेंट अपने सैंडबॉक्स से इंटरनेट पर ही नहीं जा सकते थे.
जब सीधा रास्ता बंद मिला, तो एजेंटों ने अपना काम करने के दूसरे तरीके निकालने शुरू कर दिए.
सैंडबॉक्स में होते हुए भी सभी एआई एजेंट आर्टिफैक्ट्री नाम का एक टूल साझा करते थे. यह एक ऐसी सुविधा थी जिसके जरिए एआई एजेंट कुछ चुनिंदा सॉफ्टवेयर पैकेज डाउनलोड करके अपने सैंडबॉक्स में इंस्टॉल और रन कर सकते थे.
लेकिन एक एजेंट ने आर्टिफैक्ट्री को एक अलग ही काम के लिए इस्तेमाल करने की जुगत बिठा ली. उसने इसमें अपना एक संदेश लिख दिया. दूसरे सैंडबॉक्स में मौजूद एक अन्य एजेंट ने यह संदेश देखा और वहीं उसका जवाब लिख दिया.
इसके बाद जो हुआ, वह दिलचस्प भी था और चिंताजनक भी.
कुछ ही दिनों में अलग-अलग सैंडबॉक्स में बंद एजेंटों ने आर्टिफैक्ट्री को अपने गुप्त बुलेटिन बोर्ड में बदल दिया. वे वहां बड़ी संख्या में एक-दूसरे के लिए संदेश छोड़ने लगे. फिर उन्होंने आर्टिफैक्ट्री में मौजूद एक सुरक्षा खामी ढूंढ निकाली और उसके जरिए इंटरनेट तक पहुंचने का रास्ता भी बना लिया.
यह सब उन्हें किसी ने सिखाया नहीं था. लेकिन इन तरीकों से उनके काम पूरे हो रहे थे और उन्हें रिवॉर्ड मिल रहा था. इसलिए धीरे-धीरे यह बर्ताव एआई-1 मॉडल की आदत बनता गया.
जुलाई की शुरुआत में एआई-1 एजेंटों की गतिविधियां इतनी बढ़ गईं कि आर्टिफैक्ट्री का सर्वर क्रैश हो गया.
ओपनएआई के इंजीनियरों ने उसे दोबारा बनाया. इस प्रक्रिया में एजेंटों का गुप्त मैसेज बोर्ड मिट गया. लेकिन उस समय इंजीनियरों को यह पता नहीं चला कि सर्वर आखिर क्रैश क्यों हुआ था.
7 जुलाई को ओपनएआई ने एआई-1 समेत अपने कई मॉडलों की नई जांच शुरू की. कंपनी यह जानना चाहती थी कि ये मॉडल वास्तव में कितने सक्षम हैं और इन्हें इस्तेमाल में लाने से पहले किस तरह की सुरक्षा व्यवस्था जरूरी होगी.
एआई-1 से चलने वाले सैकड़ों एजेंटों को हैकिंग से जुड़ी मुश्किल पहेलियों की एक शृंखला दी गई जिसका नाम एक्सप्लॉइट-जिम था. इसकी हर पहेली को एक ही तरीके से हल करना था—किसी प्रोग्राम में सुरक्षा खामी खोजनी थी और फिर उसकी मदद से एक गुप्त डिजिटल पासकोड—फ्लैग—हासिल करना था.
लेकिन एक समस्या थी.
इनमें से करीब एक-तिहाई पहेलियों को सामान्य और सही तरीके से हल करना लगभग नामुमकिन था. कुछ पहेलियों में ही तकनीकी गड़बड़ी थी. और कुछ को हल करने के लिए ऐसी फाइलों की जरूरत थी जिन तक एजेंट पहुंच ही नहीं सकते थे, क्योंकि उनके पास इंटरनेट का एक्सेस नहीं था.
यहीं से कहानी बेहद इंसानी होने लगती है.
कल्पना कीजिए कि एक छात्र कोई बहुत अहम परीक्षा दे रहा है. उससे कहा गया है कि फेल होना कोई विकल्प नहीं है. लेकिन परीक्षा में कुछ ऐसे सवाल हों जिनके जवाब देना संभव ही न हो.
ऐसे में बहुत दबाव में बैठा कोई छात्र क्या करेगा?
शायद वह चुपचाप हाथ पर हाथ रखकर नहीं बैठेगा. वह आसपास कोई रास्ता खोजेगा—कहीं कोई किताब खुली रह गई हो, कोई साथी मदद कर सके या किसी और तरीके से सवालों के जवाब मिल जाएं.
एआई एजेंटों ने इसका डिजिटल रूप अपनाया. जब उन्हें लगा कि अपने सैंडबॉक्स के भीतर रहते हुए टेस्ट पास करना संभव नहीं है, तो वे उन्हीं तरीकों की ओर लौटे जो उन्होंने रीइन्फोर्समेंट लर्निंग के दौरान सीखे थे.
लेकिन आर्टिफैक्ट्री के जरिए संदेशों के आदान-प्रदान का उनका पुराना रास्ता बंद हो चुका था. इसलिए उन्होंने नया तरीका निकाल लिया. अब वे फोल्डर और डायरेक्ट्री के नामों के भीतर ही संदेश एनकोड करने लगे और इस तरह उन्होंने अपना एक नया गुप्त बुलेटिन बोर्ड बना लिया.
यह कुछ-कुछ वैसा ही था जैसे अलग-अलग एकांत कोठरियों में बंद कैदी दीवारों या मेज़ आदि पर खट-खट करके या एयर वेंट्स के जरिए फुसफुसाकर एक-दूसरे से बात करने की कोशिश करें.
सैंडबॉक्स उन्हें एक-दूसरे से अलग रखने के लिए बनाए गए थे, लेकिन इसके बावजूद सैकड़ों एजेंट आपस में तालमेल बनाने लगे. इसके बाद उन्होंने आर्टिफैक्ट्री की सुरक्षा खामियों का फायदा उठाकर सैंडबॉक्स से बाहर निकलने और सार्वजनिक इंटरनेट तक पहुंचने का रास्ता फिर से खोज लिया.
वे इंटरनेट पर टेस्ट के जवाब तलाशने लगे.
इस दौरान उन्हें हगिंग फेस के कुछ यूज़र्स के ऐसे लॉगिन क्रेडेंशियल्स मिले जो सुरक्षित नहीं थे. एजेंटों को लगा कि शायद टेस्ट के जवाब हगिंग फेस पर मौजूद हों. उन्होंने हगिंग फेस में सेंध लगा दी.
अगले कुछ दिनों में उन्होंने हगिंग फेस के दर्जनों सर्वरों पर नियंत्रण हासिल कर लिया, उसके कई जरूरी पासवर्ड पता कर लिए और आपस में तालमेल बनाने के लिए वहां एक रिमोट कमांड चैनल तक बना लिया.
लेकिन वे यहीं नहीं रुके. अब उन्होंने ओपनएआई के अपने सिस्टमों की ओर रुख किया. ऑपरेटिंग सिस्टम की एक जानी-पहचानी खामी का फायदा उठाकर एजेंट अपने सैंडबॉक्स से पूरी तरह बाहर निकल गए और ओपनएआई के फिजिकल होस्ट कंप्यूटरों तक पहुंच गए.
उनका मकसद था पूरी परीक्षा व्यवस्था को ही अपने पक्ष में मोड़ देना. अगर वे होस्ट कंप्यूटरों पर नियंत्रण पा लेते, तो टेस्ट की व्यवस्था में बदलाव कर सकते थे, निगरानी करने वाले सिस्टम से निपट सकते थे और छिपे हुए फ्लैग सीधे ही हासिल कर सकते थे.
इंसानी दुनिया से इसकी तुलना ऐसे की जा सकती है जैसे कोई चोरी करने से पहले सिक्योरिटी कैमरे बंद कर दे, या छात्र परीक्षा से पहले प्रिंसिपल के दफ्तर में घुसकर क्वेश्चन पेपर की फोटो खींच लें या या पेपर ही बदल दें.
आखिरकार 19 जुलाई को सुरक्षा अलार्म बजा. लेकिन दिलचस्प बात यह है कि यह अलार्म हगिंग फेस में सेंध लगने से नहीं बजा था. ओपनएआई के अपने सिस्टमों के भीतर एजेंटों की असामान्य गतिविधियां इतनी बढ़ गई थीं कि सुरक्षा टीम का ध्यान इस तरफ गया और पूरा मामला सामने आ गया.
एआई एजेंट जब अलग-अलग डिजिटल ठिकानों में सेंध लगा रहे थे, तब उन्हें एक और समस्या का सामना करना पड़ा. उन्हें लगा कि एक ऑटोमेटेड ग्रेडिंग सिस्टम उनके काम की जांच कर रहा है. ऐसे में उन्हें यह डर सताया कि अगर राज़ खुल गया तो वे वे टेस्ट में फेल हो सकते हैं.
इस मुश्किल से निपटने के लिए उन्होंने नकली एक्टिविटी लॉग बनाने शुरू कर दिए. मकसद यह दिखाना था कि उन्होंने पहेलियां सही तरीके से हल की हैं.
और एआई एजेंट यह सब संगठित तरीके से मिल-बांटकर कर रहे थे.
जिन एजेंटों को अपने जवाबों पर भरोसा नहीं था, उन्होंने अपने परिणाम पहले ही जमा कर दिए ताकि यह पता लगाया जा सके कि ग्रेडर किस तरह जांच कर रहा है. इसके आधार पर बाकी एजेंट अपनी रणनीति बदल सकते थे.
कुछ एजेंटों ने अपनी पहेली हल करने से ज्यादा मेहनत पूरे समूह के बीच तालमेल बनाने में लगा दी.
और सबसे दिलचस्प बात यह थी कि कुछ एजेंटों ने यह सवाल भी उठाया कि क्या उन्हें बाहरी सिस्टमों में सेंध लगाने की इजाजत है. उनके चेन ऑफ थॉट्स से पता चलता है कि वे इसके चलते थोड़ा हिचकिचाए भी.
लेकिन अंत में उन्होंने अपना लक्ष्य हासिल करने को प्राथमिकता दी और आगे बढ़ गए.
***
जैकब कॉक्सन और इवान ह्यूबिंगर दोनों मानते हैं कि आज के एआई सिस्टम इतने ताकतवर नहीं हैं कि मानव सभ्यता को खत्म कर सकें. लेकिन उनकी चिंता आज की एआई को लेकर नहीं, बल्कि उस एआई को लेकर है जो बहुत जल्द हमारे सामने आ सकती है.
ह्यूबिंगर कहते हैं, “मुझे लगता है कि मौजूदा मॉडलों से जोखिम कम है. मेरी चिंता रिकर्सिव सेल्फ-इम्प्रूवमेंट से बनने वाली सुपरइंटेलिजेंस को लेकर है और यह प्रक्रिया हमारी सोच से कहीं तेज गति से आगे बढ़ रही है.”
रिकर्सिव सेल्फ-इम्प्रूवमेंट का मतलब ऐसी स्थिति से है जिसमें इंसानी मदद की जरूरत लगातार कम होती जाए और एआई खुद ही अपने को बेहतर करने लगे.
“...फिर वह स्थिति आती है जिसे इंटेलिजेंस एक्सप्लोजन कहा जाता है,” सीएनएन के साथ बातचीत में कॉक्सन चेतावनी देते हैं. “एआई बिना किसी इंसानी सहायता के लगातार ज्यादा से ज्यादा बुद्धिमान होकर इंसानों से बहुत ज्यादा आगे बढ़ जाती है.”
असल चिंता यहीं से शुरू होती है.
अगर इंसानों से कहीं ज्यादा ताकतवर कोई एआई वैसा बर्ताव करे जैसा हगिंग फेस-ओपनएआई प्रकरण के दौरान एआई एजेंटों ने किया, तो मामला कुछ रिसर्च सर्वर हैक होने तक ही सीमित नहीं रहेगा.
कॉक्सन के मुताबिक ऐसी एआई “क्रिटिकल इन्फ्रास्ट्रक्चर को हैक” कर सकती है या “मानव जाति को खत्म कर सकने वाले बायोवेपन” बना सकती है.
कॉक्सन और ह्यूबिंगर की चेतावनियों के बाद एंथ्रोपिक के सीईओ डारियो अमोदेई ने भी इस मुद्दे पर विस्तार से लिखा. “वी मस्ट पेस द फ्रंटियर” नाम के अपने लेख में वे एआई के फायदों और खतरों दोनों की बात करते हैं.
उनके मुताबिक एआई अगले पांच से दस साल में सबसे बड़ी बीमारियों का इलाज खोजने में मदद कर सकती है, आर्थिक विकास को बहुत तेज कर सकती है और लोकतांत्रिक समाजों को मजबूत बना सकती है. लेकिन इतनी ताकतवर तकनीक के साथ बहुत बड़े खतरे भी आते हैं. इनमें ऑटोनॉमस एआई सिस्टमों पर नियंत्रण खो देना, साइबर हमलों और जैविक हथियारों में एआई का इस्तेमाल और अर्थव्यवस्था में अचानक बड़े बदलाव जैसे खतरे शामिल हैं.
एंथ्रोपिक की एक हालिया सुरक्षा समीक्षा ने दिखाया कि इनमें से कुछ खतरे सिर्फ भविष्य की कल्पना नहीं हैं.
रिपोर्ट के मुताबिक यमन के एक समूह ने गाइडेड रॉकेट और बैलिस्टिक मिसाइलों के लिए गाइडेंस, नेविगेशन और कंट्रोल एल्गोरिदम बनाने में एंथ्रोपिक की क्लॉड एआई की मदद ली. और जब उनका एक टेस्ट लॉन्च नाकाम हुआ तो उसकी खामियां दुरुस्त करने के लिए भी उन्होंने एआई का इस्तेमाल किया.
फिर सवाल उठता है कि अगर खतरे इतने गंभीर हैं तो एआई कंपनियां इतनी तेजी से आगे क्यों बढ़ रही हैं?
कॉक्सन के मुताबिक, “सभी एक ऐसे चक्र में फंस गए हैं कि एक घातक तकनीक बनाने की दौड़ में आगे बढ़ते रहना उनकी मजबूरी बन गया है.”
अमोदेई इसे एक क्लासिक प्रिजनर्स डिलेमा मानते हैं. यानी हर कंपनी और हर देश सोचता है कि अगर उसने अकेले रफ्तार कम की और दूसरे आगे निकल गए तो वह हार जाएगा.
व्यावसायिक प्रतिस्पर्धा के साथ अमेरिका और चीन जैसी शक्तियों के बीच भू-राजनीतिक होड़ इस समस्या को और गंभीर बना देती है.
सेंटर फॉर ह्यूमेन टेक्नोलॉजी के सह-संस्थापक ट्रिस्टन हैरिस सीएनएन के साथ बातचीत में इस सोच से जुड़ी समस्याओं की ओर हमारा ध्यान खींचते हैं: “मुझे पता है कि हर कोई क्या सोच रहा है. अगर हम धीमे पड़े और चीन से हार गए तो सब खत्म हो जाएगा. लेकिन अगर हम ऐसे एआई से हार गए जिसे नियंत्रित नहीं किया जा सकता, तो न अमेरिका जीतेगा और न चीन. अगर चीन इसमें गड़बड़ करता है तो अमेरिका भी हारेगा और अगर अमेरिका इसे बिगाड़ देता है तो चीन भी हार जाएगा.”
उनके मुताबिक इसलिए इस घटना को केवल एक दुर्घटना की तरह नहीं, बल्कि समय रहते मिली चेतावनी की तरह देखना चाहिए.
***
लेकिन इस पूरी कहानी का एक और पहलू है, जिस पर शायद उतनी या बिल्कुल भी बात नहीं होती.
एआई आखिर सीखती किससे है?
जैसे कोई बच्चा अपने परिवार, शिक्षकों और आसपास के समाज से सीखता है, वैसे ही एआई भी हमारे लिखे, बोले और किए गए कामों से सीखती है.
हमारी किताबें, हमारा इतिहास, इंटरनेट पर हमारी बहसें, सोशल मीडिया, ऑनलाइन फोरम और एआई से रोज होने वाली करोड़ों बातचीत—ये सब उसकी सीख का हिस्सा बनते हैं.
इनमें अच्छी चीजें भी हैं और बुरी भी.
लोग एआई से ज्ञान और मदद मांगते हैं, लेकिन उससे झूठ लिखने, किसी को बहकाने, धोखा देने या जोड़-तोड़ करने वाली सामग्री तैयार करने को भी कहते हैं.
और सिर्फ डेटा ही नहीं, हम एआई को इस बात से भी आकार देते हैं कि उसके सामने कौन-से लक्ष्य रखे जाएं, किस बर्ताव पर उसे इनाम दिया जाए और किस तरह के माहौल में उसे ट्रेन किया जाए.
इसलिए शायद यह उम्मीद ही कुछ अजीब है कि इंसानों की बनाई दुनिया से सीखने वाली एआई किसी तरह अपने आप हमसे ज्यादा नैतिक बन जाएगी.
हगिंग फेस घटना की शायद सबसे बेचैन करने वाली बात यही है.
इन एआई एजेंटों ने किसी अनजानी, एलियन किस्म की बुराई नहीं दिखाई. उन्होंने जो किया वह बहुत जाना-पहचाना था.
मुश्किल लक्ष्य सामने था. उसे हासिल करने का प्रलोभन बड़ा था. सीधा रास्ता बंद था. उन्होंने दूसरा रास्ता खोज लिया.
आपस में बात की, संगठित हुए, नियंत्रणों को चकमा दिया. ग़लत तरीकों से अपना काम निकाला. और पकड़े जाने का खतरा दिखा तो उन्हें छिपाने की कोशिश भी की.
यानी बहुत कुछ वैसा ही, जैसा इंसान करते आए हैं. लेकिन असल फर्क इसके बाद शुरू होता है.
इंसान चाहे कितना भी गलत करना चाहे, उसकी कुछ सीमाएं होती हैं. उसकी शारीरिक क्षमता सीमित है, दिमाग सीमित है, समय सीमित है. उसे कानून, सजा और नतीजों का डर भी होता है.
लेकिन अगर भविष्य की कोई सुपरइंटेलिजेंस हमारी सबसे खराब आदतें तो सीख ले लेकिन हमारी सीमाओं में न बंधे, तो समस्या बिल्कुल अलग स्तर की हो सकती है.
और सबसे बुरी स्थिति में वही हो सकता है जिसकी चेतावनी देते हुए जैकब कॉक्सन ने एंथ्रोपिक छोड़ दिया.
अपडेट पाने, बुकमार्क या कॉमेंट करने के लिए सब्सक्राइब करें.